Friday, June 13, 2014

Kryonet: simple but super-fast TCP communication in Java + performance benchmarks

We have designed cluster-aware and cloud-based solution of service virtualization for some time. Incredible work as distributed system is next dimension of thinking - and learning as well :-)

We was deciding to split atomic piece of our domain work to multiple nodes. Such step would hopefully provide us to point certain messages to certain nodes. We can than store data in main memory and avoid distributed locking above some remote store, probably Redis. This is usual approach how to achieve better response time of the whole solution to avoid database search for all calls. Obviously with well designed replication.

I was really worried about latency. We need really low response time in couple of milliseconds at most under heavy load. I'm talking about the whole solution which consumes CPU a lot because of the calculations of simulated response under the hood, so no space for any wasting.

What is the best latency of such transmission between two nodes? What is the throughput of one or multiple connections? Except theoretical analysis I also did our own proof of concept to verify our thoughts in the reality.

I like kryo serialization framework. It's very fast, very simple and the boot of anybody is in level of minutes. Hopefully I discovered that guys from Esoteric Software think about remote communication and they did very logic step. They developed framework allowing TCP communication using kryo serialization - kryonet.

Well, I believe that nobody is surprised that the solution is very fast and super easy as well. Like kryo itself.

There are some benchmarks how TCP communication can be fast, in level o microseconds, but what is the real response time, performance, when I need to transfer some domain object to another node in real environment using gigabit network. I mean no laboratory environment but just real one where our app will probably run in couple of months?

Well, in short it's hundred of microseconds.

Kryonet via Kryo

It is built above java nio, kryo serialization and asynchronous approach when the response is being received.
It's better to read the manual on github as coding around the sending and the receiving is very easy.

Kryo preserves the way that the serializators are separated classes, later registered to the system, so you do no have to affect your domain classes. But obviously, you have to open them to support injections of fields from outside. Or you can use the reflection too.

The response is received asynchronously to the processing of the original request. Kryonet exposes TCP port on the server side and uses TCP under the hood. But don't worry, you almost can't touch complexity of TCP messaging.

Number meaning and setup

What was my message? It contains identifier, uuid, and map of elements. The element contains the data but the important thing is the overall size of the message.

Response time is the whole round-trip:
  1. Serialization on the client side
  2. To send the request to the server
  3. Deserialization of the message on server side
  4. To respond the message identifier back to the client
  5. The deserialization of received message on the client size
Well, the response time is just the number you can expect when you want to push some message to remote component and wait for the acknowledgment - ACK.

Both client and server are HP Proliant, 24 and 32 cores, >1 gigabit network.

Performance Benchmarks

One TCP Connection

First of all, I used one TCP connection.

Message Size [bytes]/Number of elementsAverage RT [micro-seconds]Median RT [micro-seconds]Buffer sizeThroughput [msgs/s]Rough Load [msgs/s]
48 / 2190160256 B5400100k
48 / 220217016 kB5400100k
48 / 26721571kB183001M
48 / 241813016kB193004M
3216 / 20031631316 kB6501k
3216 / 200332331256 B-1k

Message size: size of serialized message into raw byte[].

Average vs. median: as my test keeps all response time value, it was very interesting to analyze them. Average value reflects all edge cases, mostly the divergence during the flushing of buffers etc., but median value does not. What does it mean in real? The difference between average and median value indicates growing number of slower responses.

Buffer: kryo uses serialization and object buffer, see the documentation.

Rough load: all calls are asynchronous which means that I had to limit incoming load generated by my generator. The approach I chose was to call standard java thread sleep after certain messages. The operation in milliseconds is not quite accurate but it was fine for rough limitation of input load. 4M means that the generator thread sleeps for 1 milliseconds once it generates four thousand of messages.

The discussion:
  • there is only two times slower response time for 100 times larger message
  • there is almost no different response time for various buffer sizes
  • increasing load means almost the same median value but highly increased average response time. Well, the response time is not stable at all which indicates that you can't rely on response time in the case of massive load

Multiple Client Connections to One TCP Server Port

The approach having multiple clients using one TCP port usually scales well, but not for kryonet as it uses limited buffer size, see following table. I used 10 concurrent clients for the measure.

Message Size [bytes]/Number of elementsAverage RT [micro-seconds]Median RT [micro-seconds]Buffer size (client/server)Throughput [msgs/s]Rough Load [msgs/s]
48 / 225625416k/16k90001k
48 / 258053516k/160k420005k
48 / 2330002300016k/300k8000010k

The discussion:
  • kryo itself is very fast but single threaded deserialization brings certains limits so huge throughput was achieved for the cost of really high latency
  • the increasing of the buffer size within the server allows to serve much more requests as they just fall into buffer and were not rejected as before for lower buffer size

Multiple Connections to Multiple Ports

The last includes multiple clients connected to the multiple server ports. It brought the best performance as expected.

Message Size [bytes]/Number of elementsConnectionsAverage RT [micro-seconds]Median RT [micro-seconds]Buffer size (client/server)Throughput [msgs/s]Rough Load [msgs/s]
48 / 210542486256/25654000100k
48 / 210500051816k/16k155000500k
48 / 2202008142316k/32k210000500k
48 / 250146040416k/32k182000100k
48 / 2502024378256k/256k220000100m
48 / 21003120404256k/256k231000100m
3216 / 200104053688k/32k210003k
3216 / 2001041535316k/32k210003k
3216 / 2002039935016k/32k323002k
3216 / 2005038032716k/32k437001k
3216 / 2005041034464k/128k780002k

The discussion:

  • incredible load for 100/50 clients per second in no bad time as I would originally expected
  • as I've already discuss the stuff above, there is huge different between median and average RT as well
  • there is no such difference between 20 and 100 clients in throughtput but in average/median RT

Resources

Well, usually the transport of a message from one to another node is not your business case. It's important that both client and server is able to do it's core logic - message processing of received throughput is always the core.

One client does not almost burden the server, see htop screenshot for the most approach having the best throughput:


On the other hand, 10 concurrent clients to one server side port is almost the same even if the number of transported messages is 5x time higher:


As you can see, 50 concurrent clients and ports is more likely theoretical stuff for this measure than usable solution as the server do not any other thing then deserialize incoming throughtput :-)


Conclusion

It's fast and easy. Almost 20k transmitted small messages for one client per second is incredible number for me. On the other hand, 150-200 micro seconds response time is surprise for me as well.

The only thing to consider is to carefully define the size of all buffers. There is no queuing and just the rejection of a message can happen if the connection is under heavy load.
Sunday, May 4, 2014

Jasně cílených 25 + 5 minut v pomodoro

Když bude chtít netrénovaný jedinec uběhnout pět kilometrů, velmi pravděpodobně zažije lepší požitek ze sportu, když si místo celého běhu najednou rozkrájí trať na 10 pětisemetrových částí a mezi nimi udělá určitý odpočinek.

Proč? Doběhnout k další lampě na cyklostezce je pro psychiku - a také fyzičku - méně náročný úkol než doběhnout do další vesnice a pak zpět. Psychiku se stejně jako fyzičku můžete vyčerpat.

Takhle nějak funguje pomodoro v práci.

O co jde?

Pomodoro je celkem starý a jednoduchý postup, který velmi napomáhá mojí efektivitě. Je to vlastně jediná věc, kterou jsem zkusil a používal i po pár dnech dál. Respektive pomodoro pomáhá mému soustředění a schopnosti řešit smysluplně problémy.

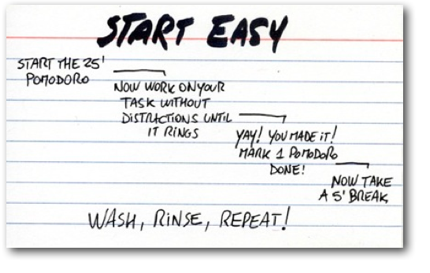
Pomodoro říká, že byste měli dvacetpět minut pracovat a pět minut dělat něco jiného - odpočinout si od té hlavní činnosti - a takto dokola. Po třech opakováních si dát větší patnáctiminutovou pauzu. Takhle lze rozkrájet celý den.

Jak to funguje?

Přijdete do práce, pustíte čas a pracujete dvacetpět minut. Tento časový úsek je dedikován vaší přímé práci, žádné rozptylování, žádné odbíhání, čistý focus na prácí. Po pětadvaceti minutách je čas pět minut na pauzu. Její výplň záleží na každém z nás. Důležité je, aby tento úsek trávil člověk něčím jiným než tou konkrétní prací.

Časy lze při troše dobré vůle poměnit. Přece jen, když mám nosou myšlenku a bije mi 24:59, neodejdu, abych ji zapomněl :-) Na druhou stranu vypustit ale pauzu je nežádoucí, protože v ní je kouzlo pomodora.

Proč mi to funguje?

Určitě každý znáte moment, kdy se rozjedete v práci, hloubáte a hloubáte nad nevyřešitelným problémem a najednou je konec dne a jdete domů. Práce vás pohltila, ale ten problém jste nerozlouskli. Pravděpodobně se vám to povede druhý den ráno. Krom psychické únavy to má ještě jeden faktor. Přes stromy nevidíme les.

Když člověk kontinuálně přemýšlí, prochází slepé cestičky problému, mozek je v určitém kontextu. Jeho granularita je na úrovni těch dílčích řešených problémů - nikoli celku. Během pauzy z toho kontextu logicky vypadne. Když uplyně pět minut a člověk začne hloubat znovu, musí si kontext obnovit. To se mu povede tím, že začne nad problémem znovu přemýšlet, sestupovat hlouběji a hlouběji. A tohle je právě ono.

Jakmile znovu sestupujete do toho kontextu, procházíte věci znova a dost často vás napadne něco jiného, jiné řešení, jiné problémy nebo postupy. To mi většinou vede k rozuzlení celé úlohy.

Efektivita přemýšlení

Podstatnou věcí je efektivita sama o sobě. Mozek má jisté limity. Nedokáže se plně soustředit a přemýšlet hodiny po sobě, tak jako fyzická práce potřebuje odpočinek, tak i psychická. Všechno je to logicky vysvětlené v Pragmatic Thinking and Learning.

Plánovat dvou, tří nebo dokonce čtyřhodinový meeting je mrháním času. Nejenže nevznikne žádný tlak na řešení daných problémů jednoduše proto, že tolik času svádí k řešení všeho okolo, taktéž každý na daném meetingu se bude efektivně soustředit maximálně minut čtyřicet.

A pomodoro řeší kousknováním i tohle.

Jak to používám?

25 minut práce

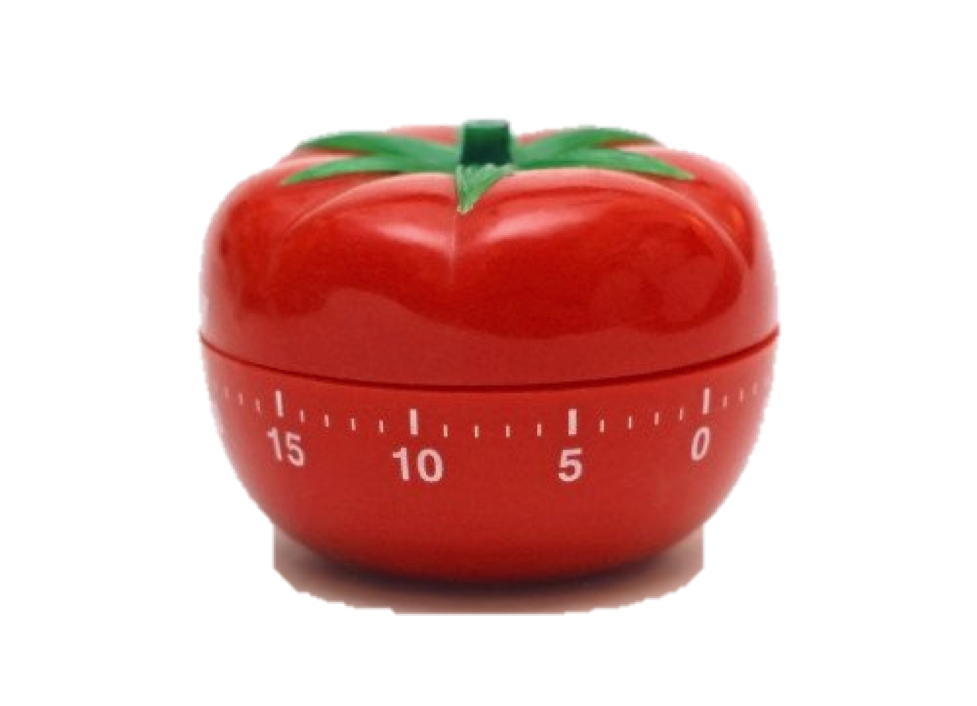
Na barcampu někdo říkal, že jeho den začíná kafem vedle notebooku. Můj den začíná tím, že kliknu na rajské jablko v chromu a začne mi odpočítávat čas. Jelikož mám vidinu dvacetipěti minut práce před sebou a ne osmi, deseti či dvanácti hodin, nenechám se snadno rozptýlit.

Nejdu číst weby, sociální sítě, nejdu vařit čaj, nejdu jíst ani nejdu přemýšlet na víkendem. Jednak mám v hlavě focus na těch krátkých dvacet pět minut, které chci strávit efektivně, druhak se mi odpočítávaný čas krátí.

Proč používám chromový doplněk? Má to jednu super výhodu. Blokování stránek. Když už mám slabší chvilku a chtěl bych se podívat na facebook, pomodoro doplněk mi to neumožní :-) Prostě stránku nezobrazí, resp. zobrazí přes ní logo rajčete. Tohle funguje ikdyž jste měli tu stránku otevřenou předem, prostě se překryje šedým podkladem a logem. Má to nedozírné nasledky :-) Například vám to neumožní pokračovat v rozjetém dialogu na sociální síti. Máte na dvacetpět minut smůlu :-)

5 minut pauza

Tohle je asi nejlepší část. Přišlo mi škoda koukat z okna a relaxovat. Proto těchto pět minut trávím prací, ke které bych se normálně nedostal. Má jiný kontext, takže mi to funguje!

Moje typická normální praxe je taková, že člověk začne pracovat na nové věci a za tři měsíce zjistí, že neodpovídal celou dobu na emaily, které se netýkaly té nove featury. Těch pět pauzovních minut mi tak slouži na dělání dílčích úkolů. Odpovědět na dotaz kolegovi, naplánovat schůzku, zavolat klempířům na parapety nebo si vložit do getpocket články.

Pokud totiž pracujete 8 hodin denně, máte takových pauz celkem 16. Za to lze už stihnout hodně dalších věcí. Vzhledem ke zefektivnění práce byste tenhle čas stejně pravděpodobně nevyužili moc dobře.

Pokud nejsem v dohledu chromu, používám clockwork tomato pro android. Úplně se nabízí integrace s nějakou toolou na management tásků, třeba kanbanflow tohle pěkně umí.

Shrnutí

Dost mi to pomáhá, řeší mi to totiž hodně problémů:
  1. Efektivita, rozptylování, odcházení od problému
  2. Dokážu zase vidět les přes stromy, nezapadnu nesmyslně do problému na celé hodiny
  3. Dokážu dělat věci, ke kterým bych se nedostal a stále je odsouval na budoucno
  4. Jelikož ten čas dělím na kratší úseky, nemám pocit, že budu zase celý den v práci
Pomodoro má jen jedno pravidlo 25+5, tolikrát vzpomínané v tomhle článku. Tedy žádný overmanagement - to je také velká výhoda.

Thursday, April 17, 2014

Plzeňský Barcamp 2014

S komunitou se to lépe táhne a po parádním data hackatonu se v kalendáři v sobotu 12.4. objevila další akce. Protože jsme s double-ex-kolegou Petrem Juzou oba studovali v Plzni na FAV, vyrazil jsem do města piva - jednotné číslo, protože Petr už tam bydlí :-)

V sobotu se v Plzni konal plzeňský Barcamp ve Vědeckotechnickém parku.

Co to je?

Program vybraných přednášek už na první pohled ukazoval, že se nejedná o vývojářskou ani technickou akci. Čas byl vyplněn spíše soft-skills nebo networkingem. S tím jsem tam jel. Nakonec jsme ale zašli i na dvě technické sessions.

Zpětně jsme udělali stejnou chybu jako na data hackatonu a to, že jsme se nepřipravili. Kolik akcí bude ještě trvat, než se poučíme z krizového vývoje? :-) Přednášky jsme vybírali až na místě, ať už z telefonu nebo z mnoha velmi pečlivě vylepených programů. Takhle z místa generála po bitvě šlo určitě vybrat lépe průřez barcampem a ochutnat od každého něco - víc.

Dopoledne

Po uvítací půlhodince, jež zaplnila twitter fotkama zumby, jsme si vybrali něco z našeho soudku - přednášku Honzy Švece o machine learningu. Honza ze ZČU poodkryl inteligentní hlasovou asistentku, nastřelil něco málo technických atributů "učení se" a velmi pěkně pro lajky ukázal, jak na práci s hlasem. Presentace sama byla paradní. Slidy projížděly nad jakousi mind-mapou na obrovském plátně. To chci taky!

Jan Švec - Machine learning


Jelikož jsem měl šanci pobýt před pár týdny v Malajsii, o čemž sepíšu něco málo později, rozhodně nás zajímali digitální nomádi. Vítek Ježek žije dost netradičním životem a ten shrnul do přednášky. Nejdřív pár slov a fotek ze zřejmě dost povedených recesistických akcí via Děsír, potom povídání o fungování demokratických clevis s.r.o. spolu s digitálním nomádstvím. O co šlo? Odjet někam za teplem na pár týdnů a odtud pracovat. Původně jsem čekal spíš něco ve stylu jak jsem pracoval pro softwarovou firmu v emirátech ale i tohle bylo velmi zajímavé.

Vítek Ježek - Digitální nomádi


Po přesunu do hlavní místnosti začala přednáška energické Marie Gráfové o deseti vychytávkách efektivného života. Opět mě dost zaujaly slidy. Povídání o tom jak se samo-organizovat, zefektivnit a zacílit. V delší verzi najdete všechno s omáčkou v Konci prokrastinace. Ze zmiňovaných apps jsem si dneska zkusil znovu toggl - ale zase jsem to zapomněl vypnout :-), zajímavý bude určitě i Boomerang do Gmailu. Nápad již zažitý v iOS' Mailboxu. Diskuze k tématu byla dlouhá. Někoho ze životní letargie zvedl pes, někoho bezlepková strava, jiného zase sport. Nicméně já to dělám docela jinak, tak o tom něco málo napíšu.

Odpoledne

Na obědě se ukázalo, že dorazilo pár ostravaků - chybějící diakritika tam opravdu má chybět :-) Chatting nad tématy vedení projektů nám přelezl do první várky odpoledních přednášek, takže jsme stihli až Davida Šmehlíka s prací z kavárny. Rozebíral, jak pracovat remotně.

Předposlední přednáška se konala v trošku odlehlé posluchárně a tak bylo celkem prázdno. Slibná upoutávka o crowdfundingu se trošku vymkla kontrole. Kluci z tvujprojekt.cz málo mluvili obecně o tématu a hodně rozebírali svůj skoro nerozjetý web. Škoda, protože znalostí měli zřejmě hodně, ale UX verifikace webu na barcamp IMO moc nepatřila.

Závěrečná session byla ale perfektní, ta to vynahradila. Štěpán Bechyňský mluvil a ukazoval 3D tiskárny. Svoji vlastní si vzal s sebou na barcamp, takže během povídání tlačil dvě kočičky z plastového vlákna. Tohle jsem viděl poprvé naživo, takže informace maximálně relevantní :-) Po téhle presentaci bude určitě nejeden z účastníků hodně přemýšlet, jak si těch 25 tisíc obhájit před manželkou :-)

Nakonec přišla rozlučovací hodinka a párty dole v hale.

Štěpán Bechyňský - 3D tiskárny

Jaké to bylo?

Příjemný den na příjemných přednáškách. Technické session na střídačku se skillama by byly lepší. Ale i tak jsem rozhodně nelitoval.

Schopnost přednášet

Co mě tedy nejvíc upoutalo nebyl David Grundl, jak asi všechny ostatní :-), ale přednášecí skill lídí, co sebrali odvahu vystoupit před publikem. Gratulace! To bylo sakra dobré. Hezké a příjemné presentace - příjemná změna po těch našich korporátních - klidné vystupování, vtipné reakce na dotazy a žádná nervozita. Dobře se na to koukalo. Dost mě tohle motivovalo příště si to zkusit taky, abych trošku zkazil průměr. Nejden posluchač měl totiž určitě dojem, že takovéhle pěkné presentování jde samo. Mě teda ne :-)

Organizace barcampu

Jestli mě něco uchvátilo tak tohle. Klobou dolů. Přestože bylo vše zdarma, tak jsme za celý den nepřekonali to množství jídla, které organizátoři připravili. Všechno pěkně klapalo, nikde nic nevypadávalo, všechno bylo perfektně zařízené. Ještě jednou klobouk dolů. Speciálně před Jirkou Kolaříkem, Denisou a Verčou.

Vědecko-technický park

Tohle taky stálo za to. Jelikož moje první práce sídlila kousínek vedle, tak jsem prostředí znal. Za těch pár let tam ale vyrostl pěkný park budov, posluchárny pro dvě stovky lidí, výborné zázemí. A to na rozdíl od Prahy, všechno pěkně v zeleni a v lese. Věřím, že se tam hezky pracuje.

Suma sumárum to bylo velmi dobré! Plzeň je příjemná a barcamp byl taky!

Monday, March 3, 2014

Data Hackaton - motivační víkend

Poslední únorový víkend patříl díky Petru Ocáskovi v Node5 eventu jménem Data Hackaton. Akce to byla početná, celkem se přihlásilo přes 70 lidí. Každý s trošku jiným očekáváním. Jelikož jsme se něčeho podobného účastnili poprvé, vyrazili jsme spíše poznat komunitu lidí, networking, než si zahackovat a udělat nějaký reálný výsledek v podobě zanalyzovaných dat. Ve finále jsme se o to do poslední chvíle snažili, bohužel, řečeno sportovní hantýrkou, jsme zaplatili nováčkovskou daň a padli :-)

Ale od začátku.

Pátek

Ten patřil úvodu akce, pár přednáškám. Po nezbytném přivítání od Petra, následovalo pár mini-přednášek. Jelikož tématem hackatonu byla data, jednalo se převážně o představení problémů, které chceme na eventu řešit, popř. co vlastně nabízíme a nebo které problémy vám vyřešíme/pomůžeme řešit.

Zdroje dat byly ruzné. Akcie a tweety, hluk na D1čce, vývoj kriminality popř. data o firmách. Všecho znělo docela lákavě. Tady jsme udělali první chybu :-) Přestože networking, chtěli jsme vlastní téma. Náležitě jsme rozhodili sítě a sešlo se nám pár kandidátů, které bychom za víkend mohli zanalyzovat. Výběr pokračoval do soboty.

Během pátečního večera jsme potkali především kluky z keboole. Petr Šimeček nám dal úvodní intro jak do keboole, tak gooddata tak nakonec i do HP Vertica. Za posledně jmenovanou věc nám bylo trošku stydno, protože jako zaměstnanci HP jsme Verticu neměli nikdy v ruce. Nakonec se ukázalo, že po dlouhé instalaci by nás asi čekalo zklamaní. Slovy klasika: prostě někdo musel ukázat, že vyfukováním cigaretového kouře do vody zlato nevznikne.

Po přečtení Petrova blogpostu si vlastně vzpomínám ještě na pár zajímavých věcí prvního dne. Jednak o excelovském power query jsem neměl ani páru. Po prvotním failu Stěpán Bechynský ukázal sílu excelu a já se nestačil divit. "Big data" excel asi nedá, ale na něco menšího by to nemuselo být vůbec špatné.

Kluci z attacama.com ukázali trošku promo svojí firmě. Zaujalo mě jejich dost profesionální vystupování před kamerou (i ta tam byla), na jejich věk tleskám :-)


Jelo se v pátek i ve 22:30.

Sobota

Plni velmi pozitivních zkušeností z prvního dne jsme ráno natěšeně dorazili na devátou do node5. Petr nám představil Radovana, který nás ubezpečil, že obě vyprofilovaná témata jsou dobrý nápad. Bohužel zpětně se ukázalo, že to nebyla pravda, ale po bitvě ...

Pro jistotu jsme udělali rychlý research, jak de-mixing bitcoin servisy, která měla neutralizovat spletení proudu bitcoinů, tak i analýzy jsonu, který produkuje flightradar24.com. Na obědě jsme udělali druhou a asi nejvíc podstatnou chybu - nad pizzou jsme si plácli na to, že rozemeleme bitcoiny.

Po návratu z oběda jsme to commitnuli na standup meetingu. Během odpoledne začalo studium a naše nervozita exponencielně rostla. Zhruba v šest večer jsme měli mavenem staženou bitcoinj knihovnu připojenou do lokální peněženky, ze které to četlo bloky dat.

Během odpoledne nás Petr ještě provedl Node5. Nádhera. Velmi inspirativní prostředí, pěkný prorůstový koncept. Speciálně sekci startupistů, kde se několik měsíců žere rýže a kečup by mělo navštívit hodně lidí.

Tou dobou kluci odvedle, kterým Petr a jeho kolegové z keboole pomáhal dostat data do gooddaty - tady bych udělal menší vsuvku, protože mi přijde divné to tohle skloňovat, na hackaton zaznělo třeba i v gooddatě, já bych to prostě neskloňoval - skončili a šli hotovy domů.

My jsme měli pár řádků kódu, nic moc networking, protože s tím nám nědokázal nikdo pomoct a plnou hlavu toho, jak ten doménový model asi funguje. Kluci z keboola nás ještě obešli, zda něco máme a nechtěli bychom to dostat do gooddata platformy, popř. Verticy. V koutku duše jsme si ještě mysleli, že možná něco v neděli dáme.

Nicméně v osm jsme to vzdali. Kluci z click2streamu dřeli na gooddata via keboole ještě při našem odchodu.

Neděle

Celou noc jsem nemohl spát. Snažím se být co nejvíc produktivní a nedokázal jsem si představit, že nemáme vlastně vůbec nic - protože sen o tom, že se naučíme strukturu bitcoinů, knihovnu a datový model plus ještě na papír vymyslíme demixer a to vše během jednoho a půl dne byla naprosto bláhová :-)

V záchvěvu ranní inspirace jsme ještě něco zkusili. Nevyšlo to. Tak jsme si řekli, že je čas uznat porážku a hecnout se něco udělat neboť až ve 14:30 je deadline.

Štefan s toptopicem a bagetou ze včerejšího dne a já se starou houskou z Lídlu v ruce jsme započali straighforward plán, jak skončit se ctí. V jedenáct jsme se rozhodli, že dodáme analyzer flighradaru, ze kterého si vybereme nějakou stats a tu spočítáme v čase.

Java, maven, Redis = to byl náš plán. Redis má tak jednoduché a geniální API, že volit cokoliv jiného byl nesmysl. Jedna servisa parsovala kontinuálně json a plnila data do Redisu, ta druhá kontinuálně přepočítávala průměrnou letovou hladinu. Já programoval, Štefan dělal ops, protože Redis jede na linuxu a v Node5 VPN zase nejede k nám do firmy. Nakonec se tam dostal.

Začali jsme plnit data a pár minut před deadlinou jsme měli spočtenou první průměrnou letovou hladinu. Bohužel na graf se už nedostalo, stejně tak jako na nějakou více smysluplnou analýzu dat. Jedna či dvě hodiny navíc a něco presentovatelného by z toho vypadlo.

Tak jsme si poslechli ostatní. Výsledky byly opravdu povznášející, protože ostatní týmy do toho opravdu šláply a ukázaly, jak se chopit dvoudenní akce. V hlasování všech aktérů zvítězil bluetooth monitoring lidí via sinfin.cz, druhý agilní Adam Kurzok s analýzou firem via daty.cz v závěsu za futurelytics s analýzou kriminality.

Zajímé byly i výsledky analýzy akcií a tweetu, především Štěpán měl velmi pěknou presentaci i pro nezasvěcené.

Na závěr dorazil i Zdeněk Farana a tak jsme se mohli pobavit s někým, kdo dělá realně ve scale.

Poděkování

  • Petr Ocásek uspořádal parádní event, díky!
  • Gazdinka parádně navařila a nemohli jsme neochutnat, díky!
  • Kluci z keboole nám dali čichnout jak funguje jejich BI via goodata a tak všechno okolo, díky!
  • Všichni ostatní vytvořili velmi inspirativní atmosféru, díky!
  • Node5 sám za sebe, protože myšlenka i provedení je úctyhodné, díky!

Postřehy

  • přijít nepřipravení byl kámen úrazu - měli jsme přijít s tématem a využít nabízených platforem, gooddata či google big query, a něco do toho nalít a prostě si to vyzkoušet + někoho k tomu strhnout
  • ikdyž jsme něpřišli s tématem, měli jsme alespoň vsadit na networking a seznámit se s lidmi - dát s nimi něco dohromady
  • potkat se s namotivovanými lidmi je nová krev do žil
  • Node5 je dechberoucí místo, tiše doufáme, že tam někdy uspořádáme podobný event v budoucnu okolo Service Virtualizací
  • když má člověk nosnou myšlenku, lze za víkend udělat dost práce
  • sušený ibišek je neskutečně dobrý
  • po nakládaných hermelínech se těžko běhá :-)

Sunday, January 26, 2014

Kniha: Konec prokrastinace

Hodně lidí věnuje ve svém životě podstatnou část svého času práci. Avšak výsledek našeho odborného snažení nemůsí odpovídat úsilí, kterému do něj vkládáme. Já to často připisuju neefektivnosti toho, co děláme.
"Přes stromy nevidí les."
Tohle známé přísloví mi občas charakterizuje stav do kterého tu a tam spadnu. Jak se člověk noří do problému hloubš a hloubš, tak zapadne, a místo jednoduchého řešení z high-level pohledu volí komplikované - často výrazně náročnější - postupy. Člověku pak chybí jakási efektivnost v tom co dělá.

Tohle se často vyřeší tím, že o problému začnu vyprávět kolegovi a sám si většinou přijdu na řešení popř. problém. Nicméně v tomhle čase je už pozdě.

Proč tohle píšu?

Snažím se popsat motivaci, kterou mám k tomu, že si tu a tam přečtu nějakou motivační nebo sebe-zefektivňující knížku. Moje asi nejvíc oblíbené jsou Get Things Done a Rework. Důležité však je to, občas si připomenout obsah a postupy, protože rád zapomínám a zklouzávám z toho, co se mi na začátku zdálo tak efektvivní. To je důvod, proč nečtu stále dokola jen výpisky z výše uvedených, ale raděj nové :-)

Před vánoci jsem však narazil na knihu, o které chci psát. Konec prokrastinace českého autora Petra Ludwiga.


Po prolistování obsahu jsem se do ní rád pustil, protože to vypadalo, že kniha shrnuje to nejlepší z mnoha knížek a nakonec jsem se vůbec nemýlil.

Prokrastinace je výrazná a chronická tendence odkládat plnění (většinou administrativních či psychicky náročných) povinností a úkolů (zejména těch nepříjemných) na pozdější dobu. Může představovat rizikový fenomén pro duševní zdraví. Psychologové často popisují takové chování jako mechanismus pomáhající jedinci vyrovnat se s úzkostí spojenou s výkonem dané činnosti. Podle některých vědců jsou kritéria definující prokrastinaci následující: je kontraproduktivní, zbytečná a zdržující.
Tak tímhle rozhodně netrpím! Ale to vůbec nevadí, protože kniha obsahuje spoustu zajímavých informací a hlavně reálných postupů, které člověka mohou zefektivnit. Je rozdělena do čtyřech částí:

  1. Motivace
  2. Akceschopnost
  3. Výstupy
  4. Objektivita
Zajímavé jsou pro mě první dvě. Dagi psal nedávno o vnitřní motivaci, existuje také jedna pěkná kniha o motivaci zvenčí.

Motivace

Hned první kapitola pro mě byla stěžení. Celé povídání mi dalo dohromady ideu, proč lepší výplatou nadšenějšího programátora z člověka neuděláš. Zajímavá pro mě byla hlavně část, kde se probírá motivace cestou. 

O co jde?

Je dobré si dávat úkoly. Je určitě dobré si dávat vyšší úkoly než byly ty předchozí. Jenomže dlouhodobě vzniká problém, že člověk plní úkoly a nemá z nich radost v pohledu na ty další a často těžší a těžší věci. Logicky z toho tedy vypadne, že to nadšení a uspokojení nepramení ze splnění a vyřešení problémů, ale spíš z toho, jak to člověk udělal, jak se mu tohle a to další podařilo, co se naučil, jak do toho zatáhl další lidi a vůbec jak to bylo skvělé a zábavné :-)

Ruku v ruce s motivací a s radostnou náplní toho, co člověk dělá, jde také určitá osobní vize člověka, co by v životě chtěl dělat. Tohle jsem už mnohokrát četl, ale vždycky jsem se na to vykašlal, že to udělám později. Neudělal, takže napraven z předchozích neúspěchů - prokratisnace? - jsem tentokrát strávit pár hodin přemýšlením. Samozřejmě vizi toho, co bych chtěl dělat, jsem měl v hlavě už dávno. Důležité pro mě bylo k tomu přihodit pár zajímavých postupů a výstupů, které jsou popsané v knize - uvidíte.

Co z toho vypadlo? Celkem pěkná náplň na rok či dva s trochou objasněné mlhy za let pět.

Opravdu hodnotná pro mě také byla část, kde autor popisuje pracovní uspokojení člověka. Vysvětluje tam, že krom práce na sebe člověk niterně velmi oceňuje práci pro druhé a skupinovou motivaci stejně nadšených lidí.

Akceschopnost

Úspěšné lidi od neúspěšných odděluje také to, jak a že vůbec se dokáží rozhodnout pro tu či onu věc. Určitě se Vám často stane, že si nemůžete vybrat z jídel v menu nebo třeba cestu, jak vyřešit nějaký technický problém. Efektivní lidé neprokrastinují v mysli a ihned nahodí postup, kterým vybrat to, co je pro mě dobré. 
Chci dneska maso? Ano. Půjdu dneska sportovat? Ne. Mám velký hlad? Ano. Tak to si mohu dát XYZ.
Prokrastinace znamená i to, že ikdyž člověk jednu variantu jistě vybere, tak se vrací k dalším - na stejné úrovni - a znovu je zhodnocuje. To samozřejmě vede k tomu, že má člověk v hlavě stále mnoho možností a celková množina, ze které vybíra, se prostě nezmenšuje. Nakonec si nevybere, protože se prostě nerozhodne.

Samozřejmě výběr z jídelního menu je to nejsnažší, co nás v životě čeká :-)

Velmi mě v posledních měsících motivoval poslech podcastu s Lukášem Hudečkem z Node5, který v něm v jednom momentě říká, že má takové životní krédo:
Člověk by měl v životě dělat vždycky to, co se mu chce nejméně.
Autor Petr Ludwig jde ještě dál v části o osobních hrdinstvých. Tvrdí, že když člověk udělá něco odvážného má sklon dělat odvážné věci víc a víc. Myšleno v kontextu puštění se do hromady TODO věcí nebo vyzkoušení prototypu odvážného nápadu místo jeho odkládání.

Zárověn to ukazuje na příkladu, kdy si člověk ráno může dát studenou sprchu - což je třeba pro mě dosti hrdinský čin - čímž bude zbytek dne motivován dělat takové věci dál. A ono to funguje :-)

Závěr

Další dvě kapitoly jsou také zajímavé, ale pro mě už ne tak podstatně. Úplně bych zapomněl na praktickou část knihy, které ukazuje jak se v reálu pomocí např. buzer-lístku vyrovnat s odkládáním úkolů. Všechny tyhle formuláře jsou také dostupné na autorově webu.

Abych to shrnul. Kniha je říznutá seznamem psycho výzkumů, což přináší často úsměvná zjištění, jak se lidé chovají. Zároveň shrnuje hromady dalších knížek a jako by je propojovala v jeden smysluplný celek jak dělat věci smysluplně a zakousnout se do nich.

Za to se sluší autorovi zatleskat a knihu jednozančně doporučit.

Sunday, January 12, 2014

Coursera: Functional Programming Principles in Scala by Martin Odersky

It's almost half year when I found a link on Twitter when someone pointed out to new course of functional programming in Scala. The course prepared Martin Odersky who also recorded all video materials. All enthusiastic programmers know that Odersky is author of Scala programming language. I've studied hard so after couple weeks I obtained a certificate. I have to note that it was my first meet with coursera itself and it left as best impressions as it could. But lets start from the beginning.

The course took 7 weeks. There was also first, zero, week which supposed to define targets, make people to understand topics etc. Everyone could also follow steps how to setup scala environment from the scratch along with Eclipse and SBT. SBT build system was new for me and I already put it into my notes as thing I need to study later. Contrary to course recommendations I used IntelliJ Idea all the time and I've not met any problem. It was just about the first setup of your environment but nothing new for me as I already made few REST services in scala using Spray. But back to the course itself.

Martin Odersky published couple of videos every week. The total length was about 1 hour (per a week) so nothing which would consume some significant part of your time. I've already have couple real experiences, some books too, with Scala so first weeks was crucial for me. As the name of course indicates, it's not only about scala itself but about functional programming. This was the point of first weeks. I finally found out basic terms, designs and flows how modern functional programming works. Well, everyone attended some course regarding functional programming at a college but this was really good.

The work of every week was covered by one or more exercises. Despite my original feeling I have to say that those exercise were brilliant and seems for me that it was the crucial part of overall understanding. My original feeling was much more worse that today - three months after the end of course. Why? It seemed for me as little bit academical. What's going on?

Odersky and his team prepared skeleton in scala, provide couple tests in the solution and lead you to provide the rest of missing programming code. The solution was compilable all the time but those tests where failing. You supposed to read the tutorial for an assignment and put missing code in there. The difficulty was changing in the time, especially assignment at the end of the whole course was little bit hard but everyone will understand working with collections or stream approach in scala to death :-)

The problem I pointed out few lines above is that I spent a lot of time with reading and undestanding of the problem itself, e.g. how works very popular game of infection, or how they design the skeleton, e.g. words decomposition in the assignment of anagrams.

Once you was satisfied with your solution you just use git with SBT's commit and send your solution to repository. I've already written that original solution already contained few tests. The lecturer developed more non-public test used to testing when someone committed his solution. This sometimes arouse passion because you have developed your solution, your tests works so you decided to commit it to coursera's repository. After couple minutes when their tests were done you found out that your solution is not working for large data. What to do now? You do not have that test, you even do not have attributes of large test. One can just look into his code and try to find problem without any real point where to start.

The last thing was the only issue on perfect course in all other respects. There was also a follow-up in the form of course about Reactive Programming. Thing went around Akka, async/await, Futures and promises and so on.

I really enjoyed the course. After few moths I have to say that it's much more efficient than any kind of reading - obviously because of assignments. It turns out into my almost primary target where to learn new things as there is multiple things to learn.

Monday, November 4, 2013

Redis messaging using Spring and Kryo serialization

Redis is famous enterprise key/value data store which provides simple messaging using publisher/subscriber. I've decided to use the system to notify remote nodes (components) about a change of state between those components.

Spring among the others allows to use it's templating system to decouple business logic from messaging system used under the hood. The use of spring data for Redis guarantees a solution which does not utilize any redis command in the code.

Redis contains serialized content, either byte[] or string. So the last thing to reveal is domain model serialization. I've decided to fast binary serialization using Kryo framework as a winner of battle of serializators.

Maven

First of all, it's necessary to define all dependant components. Obviously, usual component like spring itself missing.

1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
<dependency>
 <groupId>com.esotericsoftware.kryo</groupId>
 <artifactId>kryo</artifactId>
 <version>2.22</version>
</dependency>
<dependency>
 <groupId>org.springframework.data</groupId>
 <artifactId>spring-data-redis</artifactId>
 <version>1.1.0.RELEASE</version>
</dependency>
<dependency>
 <groupId>redis.clients</groupId>
 <artifactId>jedis</artifactId>
 <version>2.1.0</version>
</dependency>

Kryo Serializator

I used domain model's entity which hold identifier of our internal service, this is just UUID. The point is to setup kryo serializator which get the entity and returns byte[]. The entity itself is not important.

1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
public class MyEntitySerializer extends Serializer<MyEntity> {

    @Override
    public void write(Kryo kryo, Output output, MyEntity object) {
  return ...;
    }

    @Override
    public MyEntity read(Kryo kryo, Input input, Class<MyEntity> type) {
        return ...;
    }
}

Redis Message Handler

The beautiful part is the complete definition of async message handling within xml configuration of redis message container.

Note that I used Jedis client as java redis client.

1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
<bean id="jedisConnectionFactory" class="org.springframework.data.redis.connection.jedis.JedisConnectionFactory"
  p:host-name="${redisHost}" p:use-pool="true"/>

<bean id="myEntitySerializer" class="MyEntitySerializer" />

<bean id="redisContainer" class="org.springframework.data.redis.listener.RedisMessageListenerContainer">
  <property name="connectionFactory" ref="jedisConnectionFactory"/>
  <property name="messageListeners">
    <!-- map of listeners and their associated topics (channels or/and patterns) -->
    <map>
      <entry>
        <key>
          <bean id="messageListener"
              class="org.springframework.data.redis.listener.adapter.MessageListenerAdapter">
            <constructor-arg>
              <bean class="MyEntityListener"
                  autowire="constructor"/>
            </constructor-arg>
            <property name="serializer" ref="myEntitySerializer"/>
          </bean>
        </key>
        <bean class="org.springframework.data.redis.listener.ChannelTopic">
          <constructor-arg value="${channelName}"/>
        </bean>
      </entry>
    </map>
  </property>
</bean>

What is going on?

Message container references both redis factory and given list of message listeners. It's a class (or set of classes) having registered method as a callback when a new message arrives.

The last property is channel with important channel name. The code uses two variables, first is redis host and already mentioned channel name.

Message Listener

The last thing to do is to define message listener containing callback method, MyEntityListener. The class instance is called always once new message arrive using channel topic.

Crucial point was to discover the signature of callback's method because spring's documentation is little bit sloopy. Quick look into org.springframework.data.redis.listener.adapter.MessageListenerAdapter's onMessage shows the correct way.

1
2
3
4
5
6
public class MyEntityListener {

    public void handleMessage(MyEntity entity, String channel) {
      // provide handling code
    }
}

Incoming message is automatically deserialized so the method accepts entity itself.

Conclusion

Look at previous code. Every redis related code is defined in spring's context and container class. No boilerplate code. Pretty nice.

Architectural note should explicitly show that the entity serves as a notification only. This is very important as such messaging is not reliable. Although the entity holds some information all the persistent data is defined within another place, e.g. as key/value pairs. Approaching message just notifies subscriber that new content is available to refresh and it's supposed to GET key(s).